静止画1枚と音声ファイルから、ffmpegで数時間の長尺動画を自動生成しています。その構成と、実際に運用して分かった「サーバーが巻き添えで遅くなる」「ディスクが埋まる」という2つの落とし穴、そして43万通りの組み合わせをどう管理しているかをまとめます。
やっていることはシンプルです
やっている中身は驚くほど単純で、静止画1枚と音声ファイルをffmpegに渡して、数時間ぶんの動画ファイルを書き出すだけです。映像は動きません。音楽が流れているあいだ、同じ画像がずっと表示されているタイプの動画です。
単純だからこそ自動化しやすく、Python側でやることは「どの曲に、どのタイトルで、どの画像を組み合わせるか」を決めて、ffmpegを呼び、後片付けをする、という流れになります。難しいのは動画を作ることではなく、作り続けたときに周りを壊さないことでした。
組み合わせは434,700通りある
素材は3種類あります。タイトルのパターン、曲、背景画像です。
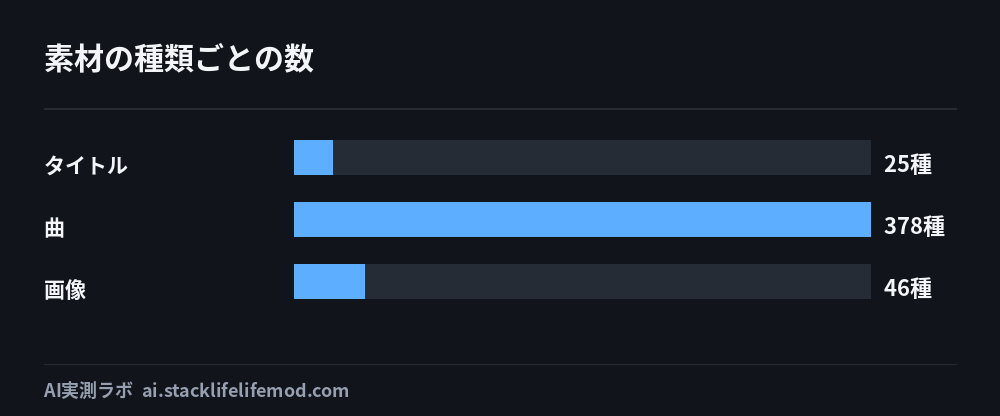
数字だけ見ると無尽蔵に思えますが、放っておくと同じ組み合わせを何度も引きます。ランダムに選ぶ実装のままだと、体感でぶつかります。そこで使用済みの組み合わせを記録して、次回以降はそれを避けるようにしました。生成のたびに「この曲・このタイトル・この画像」の組を記録し、選定時に既出を除外します。
組み合わせ総数が多いことと、重複しないことは別問題です。「使った組み合わせを覚えておく」という一手間を入れるかどうかで、出てくるものの見え方が変わります。
落とし穴1:書き出し中にWebサイトが遅くなる
これが最初にぶつかった問題です。動画生成はCPUを大きく使います。同じサーバーでWebサイトを動かしていると、書き出し中にサイトのレスポンスが目に見えて遅くなりました。
対策として、ffmpegの実行を次の2つでくるんでいます。
tasksetで使用するCPUコアを2つに限定するniceでプロセスの優先度を下げる
コアを絞って優先度を下げたことで、書き出し中でもWebサイト側が巻き添えになる状況は避けられるようになりました。動画生成はバックグラウンドの仕事だと割り切って、CPUを全部使わせないという判断です。
書き出し自体は当然その分ゆっくりになりますが、長尺動画の生成は急ぐ必要がありません。急ぐ必要がない処理にCPUを全部渡してしまうのが、そもそも設計ミスでした。
落とし穴2:ディスクが埋まる
数時間の動画ファイルは大きいです。生成して、アップロードして、そのまま置いておくとディスクが埋まります。実際に埋まってから気づく類の問題です。
いまは生成後に動画ファイルとサムネイルを削除する処理を、パイプラインの最後に必ず入れています。
削除を「あとでまとめてやる」にすると、まとめてやる前に容量が尽きます。生成→アップロード→削除、までを1本の流れとして完結させるのが安全です。
タイトルは2つ持てる
運用してみて便利だったのが、動画に焼き込む(burned-in)タイトルと、YouTube側に設定するタイトルを別々に持てるという点です。
| 種類 | 用途 |
|---|---|
| burned-inタイトル | 動画の映像そのものに入るタイトル |
| YouTube側のタイトル | プラットフォーム上に表示されるタイトル |
この2つが独立しているので、日本語タイトルを別途付けることができます。映像に焼き込んだ文字列を変えずに、プラットフォーム側の見せ方だけ変えられるのは、あとから調整する余地が残るという意味で助かっています。
まだ分かっていないこと
- タイトルの付け方の違いが、実際にどれくらい結果に効いているのかは検証できていません
- コアを2つに絞るのが最適なのかも、他の値と比較したわけではありません。Webサイトが遅くならない、という条件を満たす設定を1つ見つけただけです
最初は「動画を作る」ことだけを考えて自動化しました。結果、CPUを食い尽くしてWebサイトを遅くし、生成物を消し忘れてディスクを埋めました。自動化で壊れるのは、自動化した対象ではなく、その周りです。
- 静止画1枚+音声で数時間の動画をffmpegで生成。処理自体は単純
- タイトル25種×曲378本×画像46枚=434,700通り。使用済みの組み合わせを記録して重複を避ける
- CPUを食うので
tasksetで2コアに限定しniceで優先度を下げる。しないと同居のWebサイトが遅くなる - 生成後に動画とサムネイルを削除する。しないとディスクが埋まる
- burned-inタイトルとYouTube側タイトルは別管理でき、日本語タイトルを別途付けられる