Claude APIで記事を毎日自動生成していると、SDKの自動リトライが効かないエラーに定期的にぶつかります。この記事では、構造化出力で返ってくる Grammar compilation timed out. を「400番なのに再試行すべきエラー」として扱った話と、エラーログの取り方で原因究明に失敗した話をまとめます。
毎日動かしていると「再試行されないエラー」に気づく
Claude APIで記事を毎日自動生成しています。出力の形を安定させたいので、構造化出力(JSON Schema指定)を使っています。ここで時々返ってくるのが、次のエラーです。
Grammar compilation timed out.
最初はスキーマの書き方を間違えたのだと思いました。HTTP 400、つまりクライアントエラーとして返ってくるからです。400は「あなたの送ったリクエストがおかしい」という意味なので、当然こちらのミスを疑います。
ところが、同じリクエストをもう一度投げると普通に通ります。スキーマは何も直していません。つまりこれは、リクエストが壊れているのではなく、一時的な混雑で起きているだけのエラーでした。
400番だからリクエストの不備だと決めつけて、スキーマを何度も見直しました。実際には投げ直すだけで通るエラーでした。
SDKの max_retries はここで助けてくれない
SDKには max_retries があります。しかしこの設定は400番を再試行しません。リクエストが悪いという扱いなので、何度投げても同じという判断です。判断としては正しいのですが、今回のエラーはその例外にあたります。
「max_retries を設定してあるから通信の失敗は自動で吸収される」と思っていると、400番で返ってくるこの種のエラーだけが素通りで落ちます。自動リトライの対象外が何かを知らないと、原因の見当がつきません。
対処:このメッセージのときだけ自前で再試行する
やったことはシンプルです。エラーメッセージが Grammar compilation timed out. のときに限って、自分でリトライを入れました。
- APIから400が返ったら、まずエラーメッセージを確認する
Grammar compilation timed out.が含まれていれば再試行する- 待ち時間は20秒 → 40秒 → 60秒と延ばす
- 最大4回まで試して、それでも失敗なら諦めてエラーとして扱う
重要なのはメッセージで絞り込んでいる点です。実装が楽なので「400番なら全部再試行する」にしたくなりますが、これはやめました。
全部の400番を再試行すると、本当にリクエストが壊れているときに気づけなくなります。スキーマの記述ミスやパラメータの誤りも、ただ「数回リトライして最後に失敗するジョブ」に見えてしまいます。原因が混ざるのが一番やっかいです。
ストリーミングを使うかどうかの判断
もうひとつ、実運用で意識しているのがストリーミングです。長い入力・長い出力・大きな max_tokens のいずれかに当てはまるなら、ストリーミングを使うほうが安全です。非ストリーミングで長時間の応答を待つ構成は、それだけで失敗しやすい形になります。
コストは「実行するほう」より「探すほう」が高いことがある
別のAPIの話ですが、コスト感の見積もりを外した例として書いておきます。YouTube Data APIのユニット消費です。
| 操作 | 消費ユニット |
|---|---|
| 動画検索 | 100ユニット/回 |
| コメント投稿 | 50ユニット/回 |
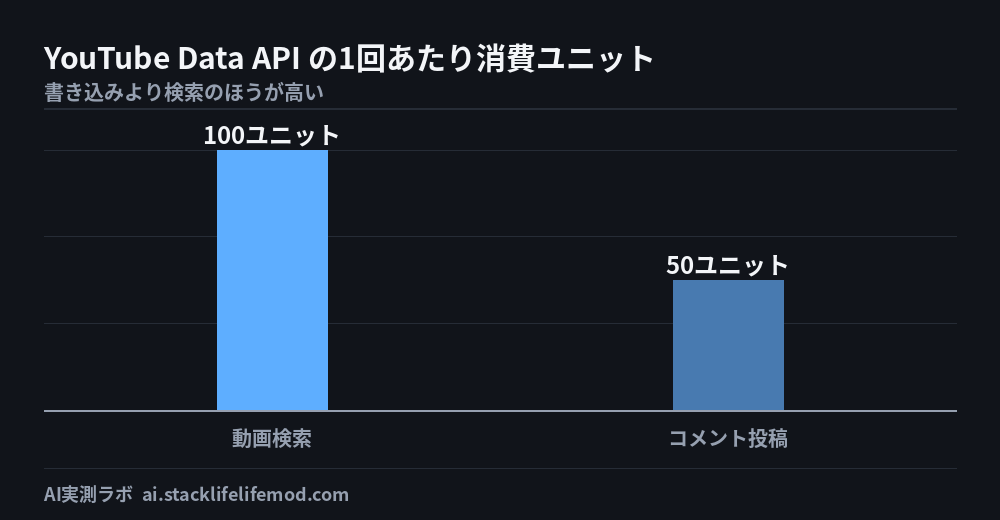
感覚としては「書き込むほうが重い」と思いがちですが、探すほうが2倍高いのです。つまり、投稿数を絞っても検索を無駄に回していれば節約になりません。削るべきは検索の回数です。
エラーログに str(e) だけを書いていて詰んだ話
ここが今回いちばん反省した点です。エラーログに str(e) だけを記録していました。普段はこれで十分読めます。
ところが、中身が空の例外に遭遇して、原因がまったく分からなくなりました。ログには何も書かれていない行が残るだけです。何が起きたのか、どこで落ちたのかも分かりません。
str(e) が空文字の例外は普通に存在します。そのときログは「失敗した」という事実しか残しません。再現もできず、この回については原因不明のままです。
いまは、例外の型名とトレースバックの最後の1行を必ず添えるようにしました。
- 例外の型名 … メッセージが空でも「何の例外か」は分かる
- トレースバックの最後の1行 … どこで落ちたかが分かる
この2つを足しただけで、ログを見た瞬間に切り分けられる範囲が変わりました。メッセージ本文は空になり得るが、型名と発生位置は空にならないという前提でログを設計するべきでした。
分かっていないこと
正直に書いておくと、Grammar compilation timed out. がどういう条件で出やすいのかは分かっていません。混雑によるものだと理解していますが、こちら側のスキーマの複雑さで発生率が変わるのかどうかも確かめられていません。今のところ「出たら決まった回数だけ投げ直す」で運用が回っているので、そこで止めています。
空の例外についても、何の例外だったのかログに残っていないため、原因は不明のままです。分かっていないことは分かっていないとして扱い、次に出たときに情報が取れる状態にしておく、というのが現実的な落としどころだと思っています。
- 構造化出力で
Grammar compilation timed out.が400番として返ることがあり、一時的な混雑なのでもう一度投げれば通る - SDKの
max_retriesは400番を再試行しないため、このエラーは自動リトライでは救われない - 対処はメッセージ限定の自前リトライ(20秒・40秒・60秒待ちで最大4回)
- 400番を全部再試行すると、本当にリクエストが壊れているときに気づけなくなる
- 長い入力・長い出力・大きな
max_tokensのいずれかなら、ストリーミングのほうが安全 - YouTube Data APIは動画検索100ユニット/コメント投稿50ユニットで、探すほうが高い
- エラーログは
str(e)だけでは空になり得る。例外の型名とトレースバック最終行を必ず添える